
IA diminuta vence a OpenAI en razonamiento: el HRM desafía al Transformer
Antetítulo: IA diminuta vence a OpenAI en razonamiento en ARC-AGI con solo 27M de parámetros
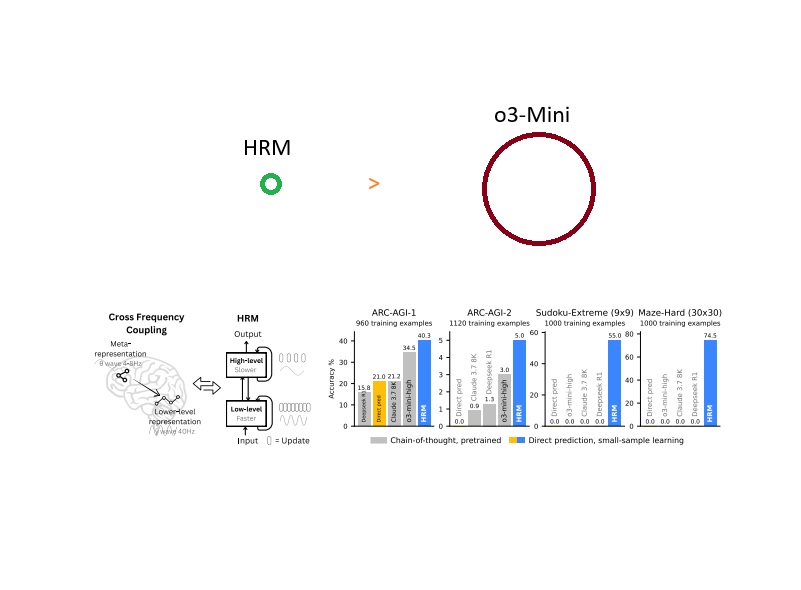
Una arquitectura nueva, Hierarchical Reasoning Model (HRM), logró mejores resultados que modelos de OpenAI como o3-mini-high en ARC-AGI pese a tener apenas 27 millones de parámetros y entrenarse con ~1.000 ejemplos. Además, resuelve Sudoku extremos y laberintos 30×30 casi a la perfección sin pre-entrenamiento ni cadenas de pensamiento. El hallazgo cuestiona la primacía del Transformer en tareas de razonamiento secuencial. ar5iv
Cómo pasó (la historia en breve). Inspirado en la jerarquía y múltiples escalas temporales del cerebro humano, HRM combina dos módulos recurrentes: uno lento y abstracto que planifica y otro rápido y detallista que ejecuta; juntos avanzan por ciclos hasta converger en la solución. Con este diseño y un entrenamiento eficiente (sin BPTT), el modelo alcanza 40,3% en ARC-AGI y supera a o3-mini-high (34,5%) y Claude 3.7 8K, con un contexto de 30×30 (900 tokens). ar5iv
Referencia divulgativa: el video “Una IA diminuta ha vencido a OpenAI en razonamiento” resume el enfoque y sus implicaciones para el ecosistema actual. YouTube
Temas clave (paso a paso)
- Arquitectura jerárquica inspirada en el cerebro
HRM replica un módulo de alto nivel para estrategia y otro de bajo nivel para cómputo rápido, operando a distintas escalas de tiempo para profundizar en el razonamiento. IA diminuta vence a OpenAI en razonamiento porque esta estructura evita los límites de profundidad efectiva del Transformer. ar5iv - Ejecución secuencial en un solo “forward pass”
El modelo razona de forma latente sin depender de Chain-of-Thought explícito ni de datos CoT, reduciendo latencia y dependencia de grandes corpus. ar5iv - Entrenamiento estable y eficiente
HRM propone una aproximación de gradiente en un paso que elimina BPTT, mantiene memoria constante y evita convergencia temprana típica de RNN. ar5iv - Adaptive Compute Time (ACT)
El sistema decide cuándo parar o seguir “pensando”, ahorrando cómputo sin perder rendimiento, clave para escalabilidad práctica. ar5iv - Resultados en benchmarks
- Sudoku-Extreme y Maze-Hard 30×30: casi perfectos sin preentrenamiento.
- ARC-AGI: 40,3% (HRM, 27M) > o3-mini-high 34,5% y Claude 3.7 8K 21,2%; entrenado solo con el conjunto oficial (~1.000 ejemplos). Aquí, IA diminuta vence a OpenAI en razonamiento de manera concreta y medible. ar5iv
- Recursos y código
El artículo enlaza a repositorios y checkpoints (Hugging Face/Spaces, Replicate, etc.) para reproducibilidad y pruebas públicas. arXiv - Contexto del debate
El video fuente contrasta predicción de tokens (Transformers) con razonamiento secuencial y sitúa a HRM como alternativa cuando la cadena de pensamiento no basta. YouTube
Conclusión
IA diminuta vence a OpenAI en razonamiento es más que un eslogan: los datos en ARC-AGI, junto con Sudoku y laberintos, colocan a HRM como candidato serio a liderar la próxima ola de arquitecturas orientadas a razonamiento profundo y eficiente. El campo deberá decidir si adopta modelos jerárquicos recurrentes para superar los límites del Transformer. Gracias por leer.
| Aspecto | HRM (27M) | o3-mini-high (OpenAI) | Claude 3.7 (8K) |
|---|---|---|---|
| Tipo de arquitectura | Recurrente jerárquica (módulo “alto” planifica, módulo “bajo” ejecuta) a distintas escalas de tiempo. | LLM con enfoque de Chain-of-Thought (CoT) para descomponer pasos. | LLM con enfoque CoT para razonamiento guiado por texto. |
| Tamaño del modelo | ~27 millones de parámetros. | No público; considerablemente mayor que HRM. | No público. |
| Datos usados para la tarea | ~1.000 ejemplos (conjunto oficial) y sin preentrenamiento. | Modelo preentrenado a gran escala; detalles de afinado en ARC no públicos. | Modelo preentrenado a gran escala; detalles de afinado en ARC no públicos. |
| Cadena de pensamiento (CoT) | No usa CoT; realiza “razonamiento latente” en un solo forward pass. | Se apoya en CoT (texto intermedio) y genera más tokens. | Se apoya en CoT (texto intermedio). |
| Control del cómputo | Adaptive Compute Time: decide cuándo parar o seguir pensando. | Sin ACT declarado; la CoT suele aumentar latencia por más pasos/tokens. | Sin ACT declarado; CoT incrementa tokens y latencia. |
| Ventana de contexto (en la prueba ARC) | Cuadrícula 30×30 (≈900 tokens). | Significativamente mayor (no público). | 8K. |
| Resultado en ARC-AGI | 40,3% | 34,5% (o3-mini-high) | 21,2% (8K) |
| Sudoku “Extreme” | Casi perfecto sin preentrenamiento. | Los métodos CoT SOTA fallan (0%). | Los métodos CoT SOTA fallan (0%). |
| Laberintos 30×30 | Ruta óptima, casi perfecto sin preentrenamiento. | Los métodos CoT SOTA fallan (0%). | Los métodos CoT SOTA fallan (0%). |
| Disponibilidad | Paper y demos públicos; enlaces a repositorios y checkpoints. | Propietario. | Propietario. |
Cómo leerla: HRM es un modelo pequeño que razona por ciclos internos (sin “pensar en voz alta” con texto) y aprende la tarea con muy pocos ejemplos. En ARC-AGI supera a o3-mini-high y Claude 3.7 (8K) pese a usar menos datos, menos parámetros y una ventana de contexto mucho menor.
Fuente técnica: arXiv v3 (4 ago 2025). Resultados y descripciones de HRM, ARC-AGI (40,3% vs. 34,5% y 21,2%), Sudoku y laberintos, razonamiento latente y ACT. Ver el paper y sus enlaces a código/demos.